高通的骁龙技术峰会落幕,今年的芯片包括天玑高通和苹果甚至于说lunar lake传递出多个信号性能与能效的平衡多模态AI以及制程的担忧
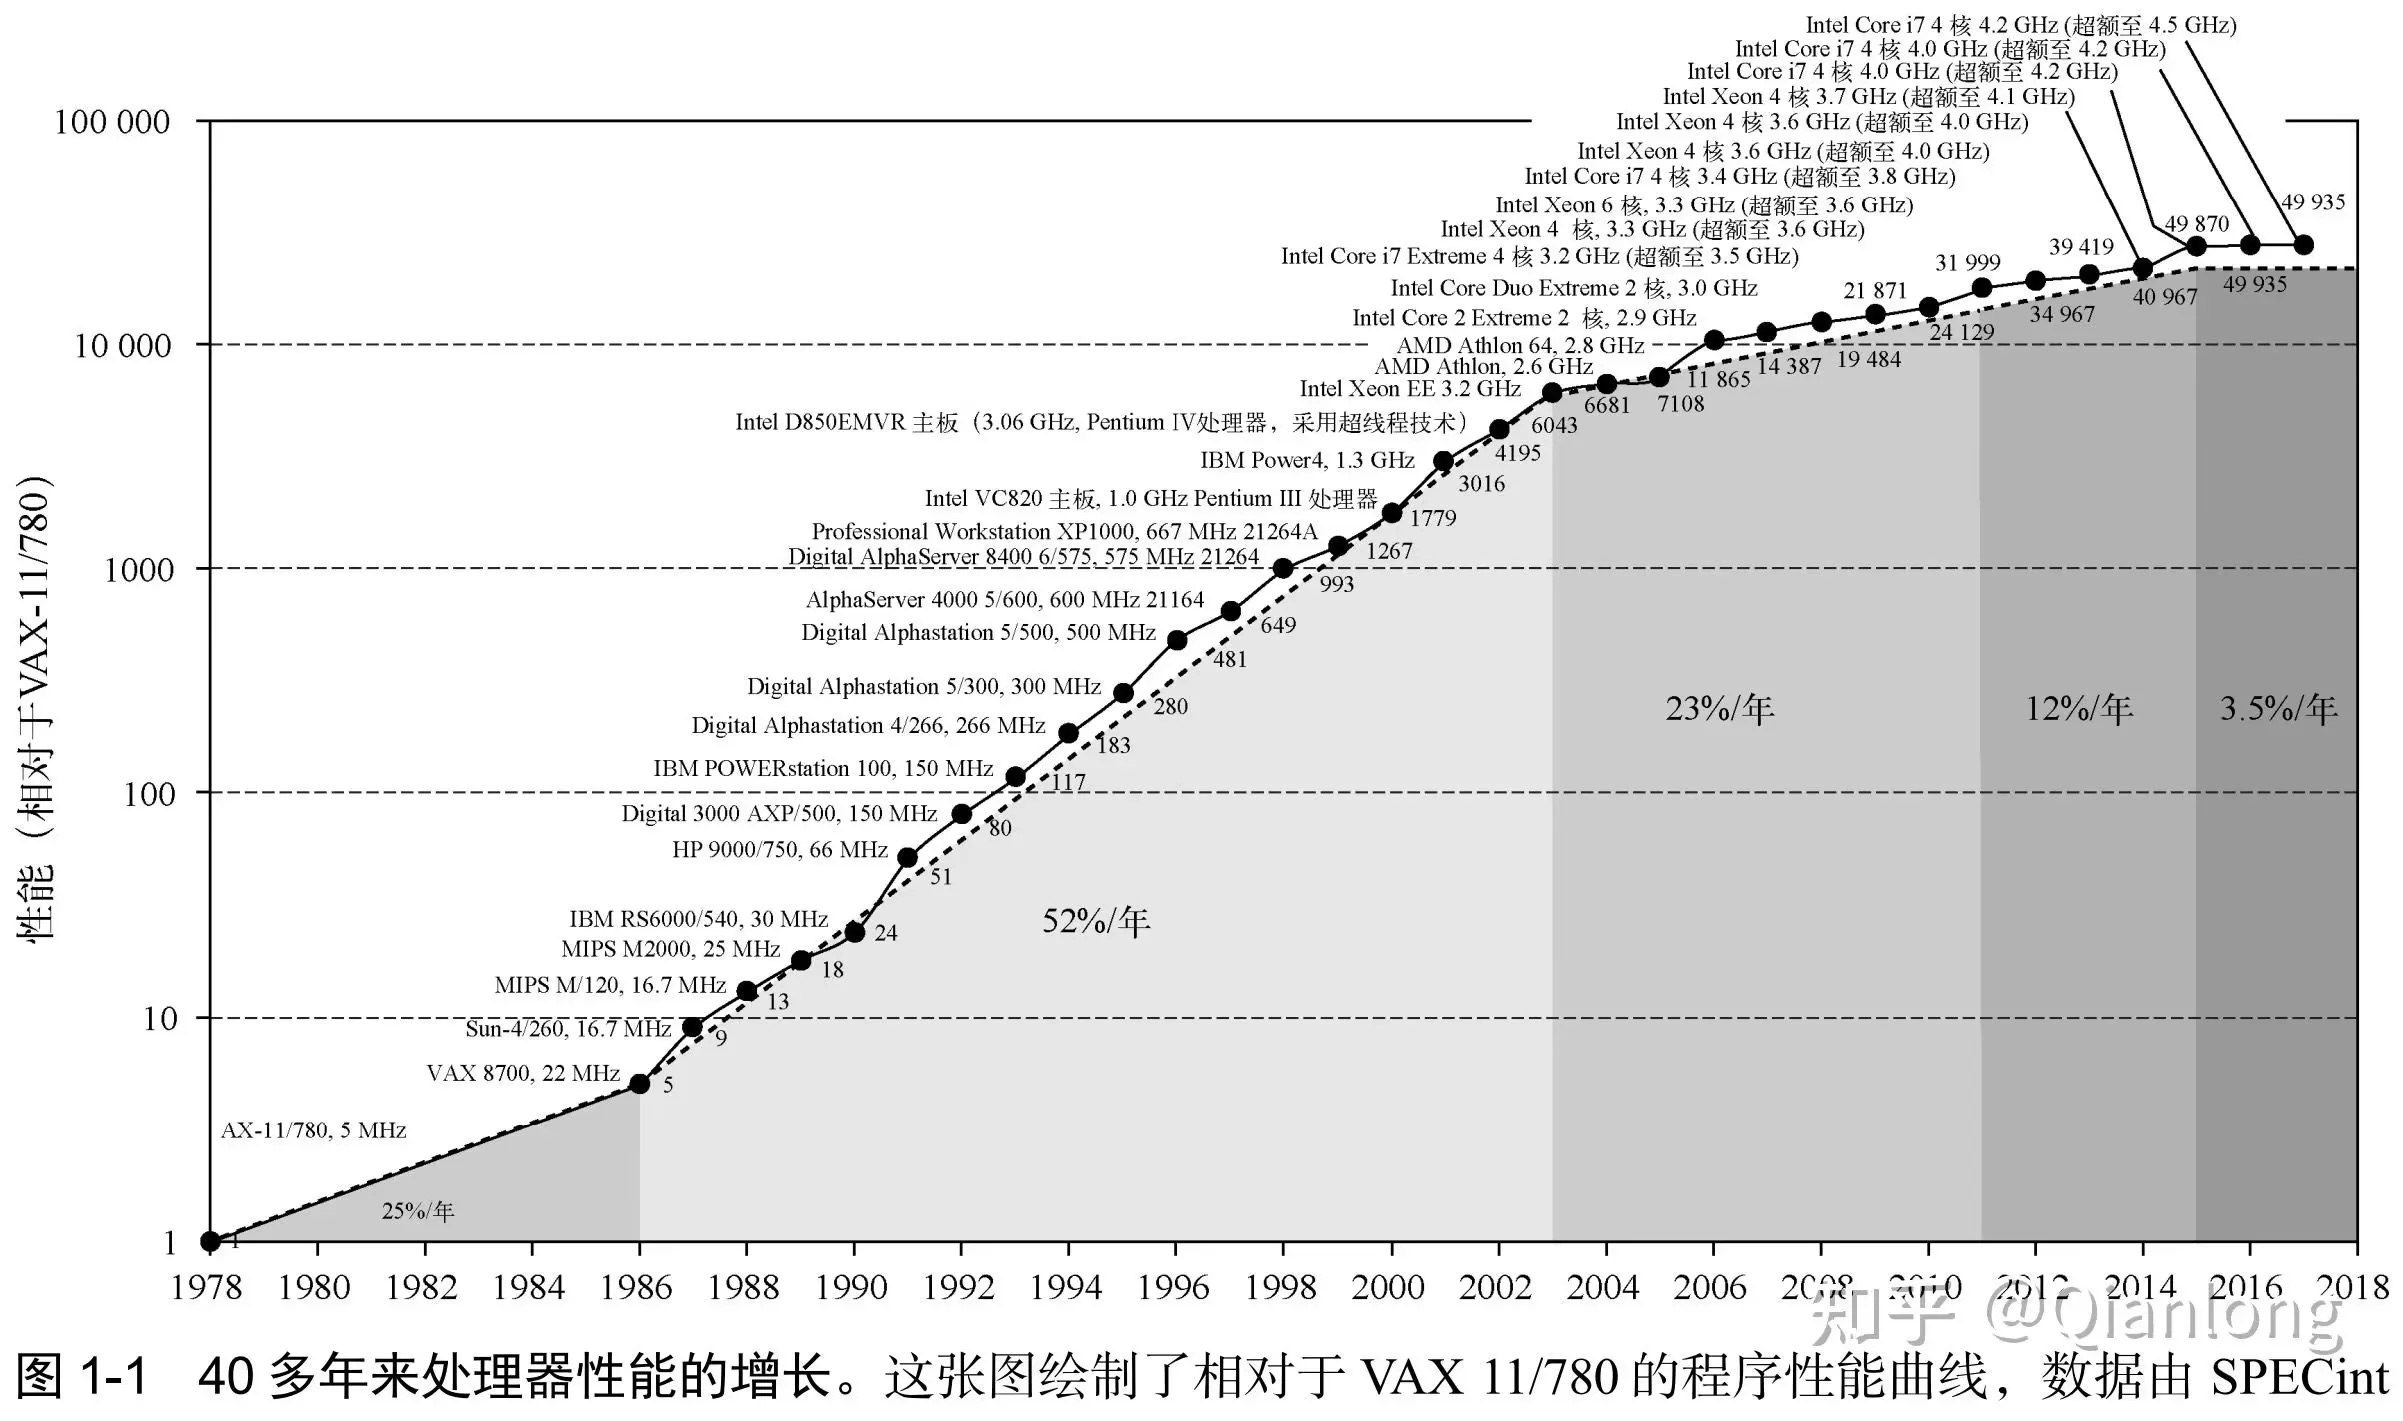
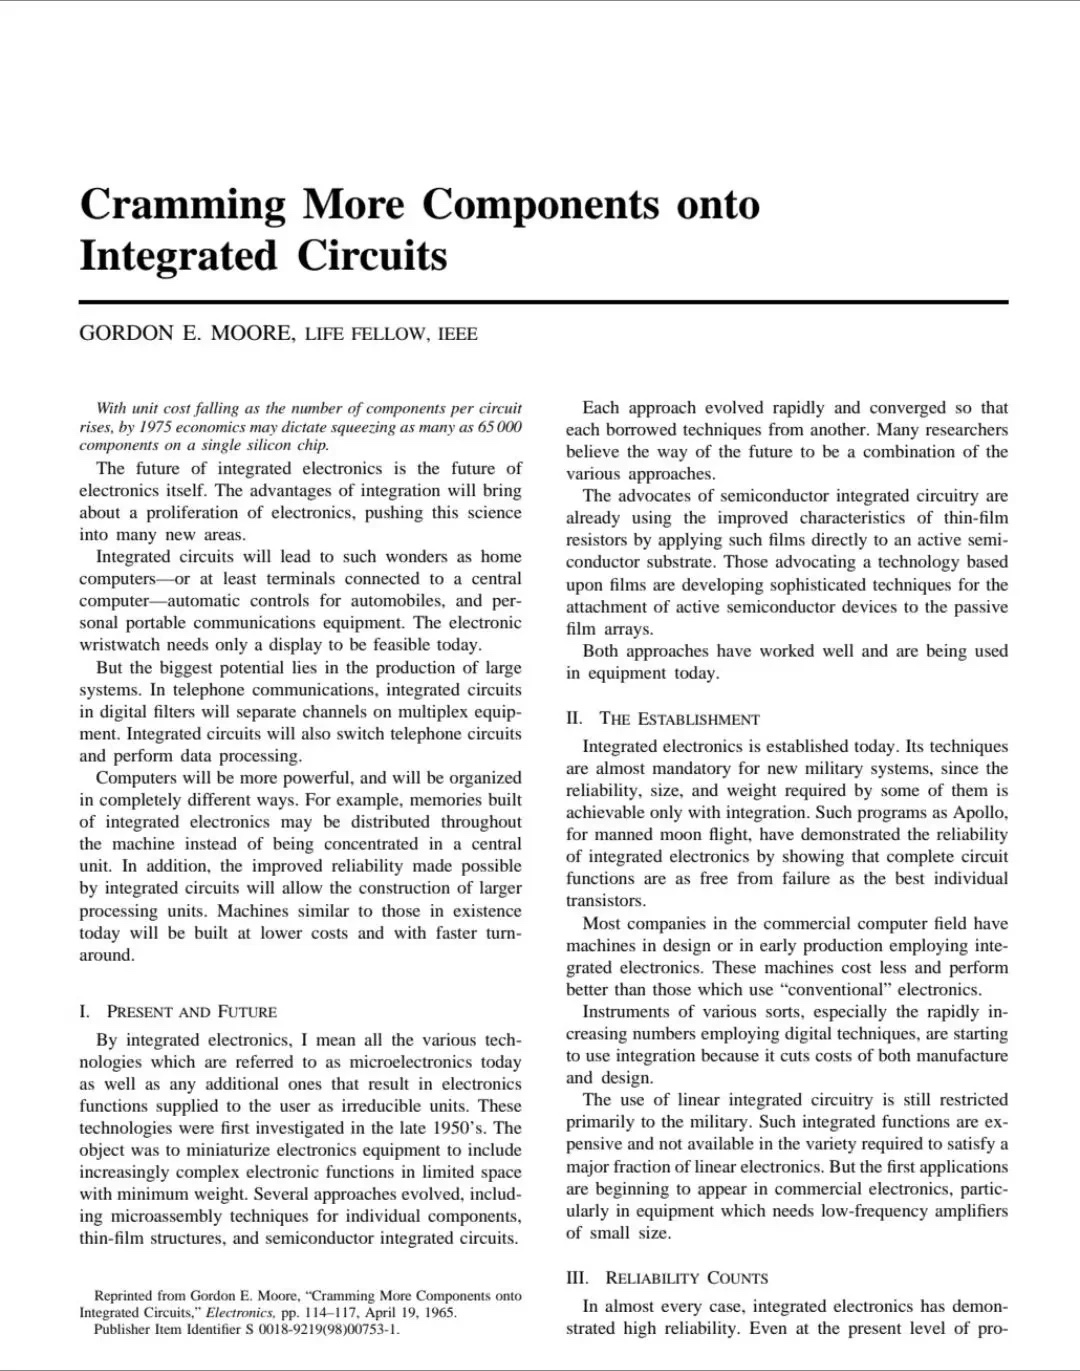
很多人也讲摩尔定理限制,首先摩尔定理它并非一个物理定理,它是对于某种规律的总结。其次,摩尔在他最后一页论文给出了解决方案异构——芯片级、软件级、系统级别,原论文地址网页链接摩尔定理)
制程的担忧,从去年的第四季度开始,台积电N3E工艺已经开始量产,但为什么直到今年的下半年之前只有m4使用了该工艺
苹果能用上N3E是苹果有钱,而且苹果现在造的芯片面积也不算大,刚好契合早期先进工艺的发展情况,对于良率不是特别高的工艺,芯片面积越小则越容易如期量产。而N3E是今年最新的工艺,只有苹果才会来赶这一趟。
N3的故事很复杂。最初,考虑到不温不火的性能、功率和密度改进,N3的产量和价格都具有挑战性,超出了大多数客户愿意支付的价格。它有大约25个EUV层,几乎是N5的两倍。N3出现了许多问题,最终导致台积电错过了典型的2年主要工艺节点发布周期。
由于N3B未能达到台积电的性能、功率和产量目标,因此开发了N3E。其目的是修复N3B的缺点。第一个重大变化是金属间距略有放松。台积电没有在MO、M1和M2金属层上使用多重图案化EUV,而是退缩并切换到单一图案化。
你要知道,这项重大改动是基于台积电其24小时不间断研发的理念,赶工一年多出来的,可见开发难度,更枉论其他的代工厂商
近年来,芯片设计人员严重依赖 SRAM 来提高性能。SRAM 缩放的消亡带走了提高性能的一个重要杠杆,并将增加架构在提高功率和性能特征方面的重要性。毕竟这简单,方便,可操作型线性
但遇上这么个事儿,思思路肯定是要变一变的。以骁龙8Elite为例
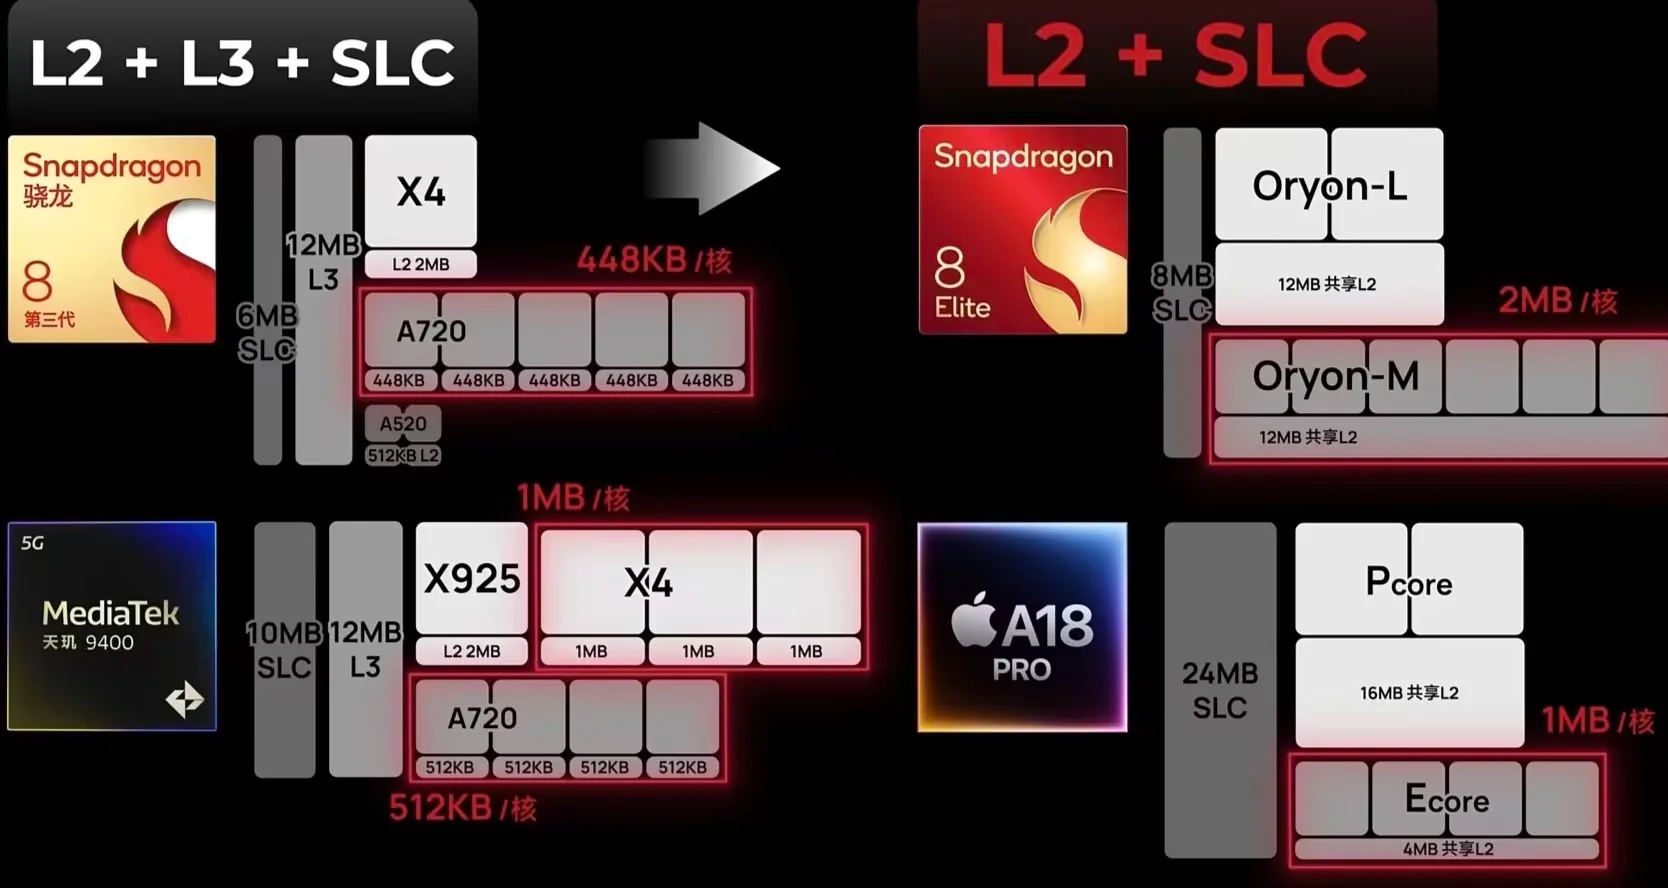
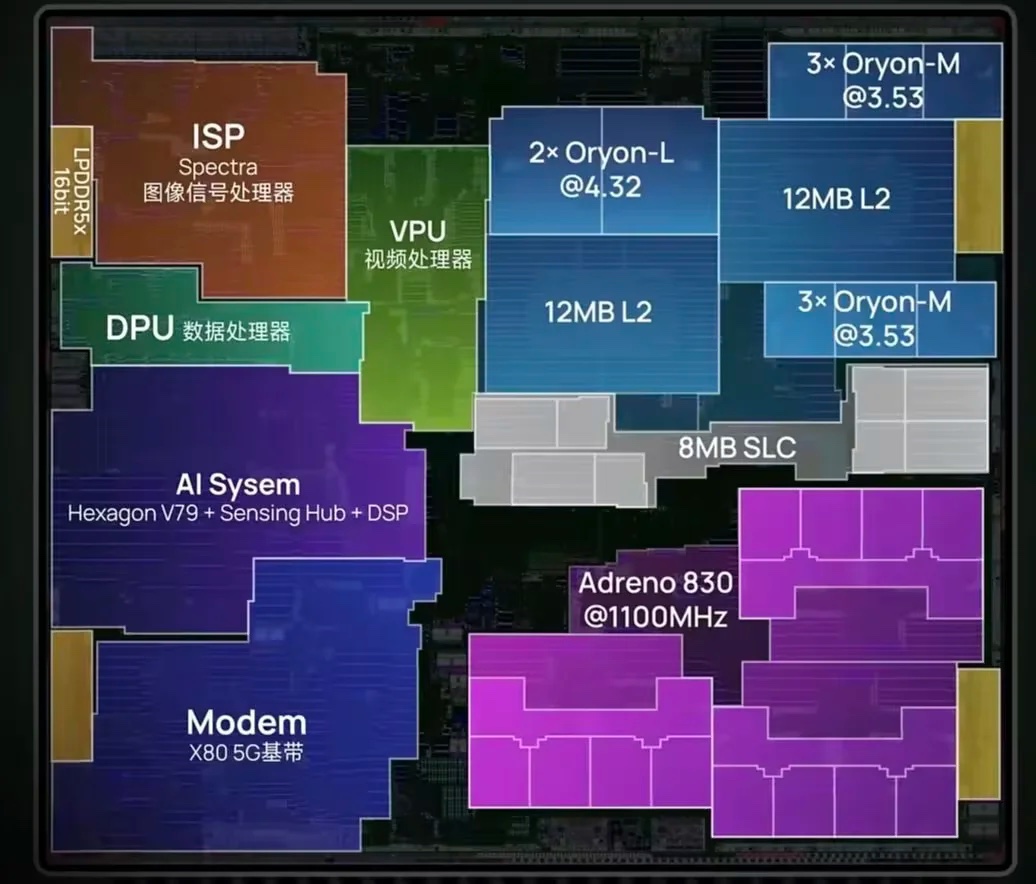
这一次Oryon架构用在了手机处理器上,并且高通宣称骁龙8 Elite搭载的是第2代Oryon 架构。除了架构的改变之外,核心组合也发生了变化,由上代的1+5+2变成了2+6,拋弃了小核心,2个超大核+6个大核,并且主频给的非常高,超大核直接顶到了4.32GHz, 大核也有3.53GHz,这是至今为止主频最高的手机CPU(之前发布的天玑9400Cortex-X925超大核主频3.63GHz,苹果A18 Pro也刚到4.04GHz),除了主频之外,缓存配置变动很大,这一次直接给了24MB 的二级缓存,已经取消了三级缓存,改为PE核设计2颗超大核共享12MB,6颗大核共享12MB,不再采用每颗核心单独配备二级缓存的方式,去掉了三级缓存,系统级缓存从6MB增加至8MB,这个设计风格正是和苹果A系列相同,毕竟算是同一个团队的产品。
你要是放在以前,高通肯定是不乐意这么做的,高通第一次这样应用到移动端芯片时,还是因为32位系统并不成熟,原本的arm公版不能适配。如今放下arm公版,可以说是在未来做准备。在未来几年,芯片在制程上将会越来越拉不开差距,只有靠过硬的内在设计能力才能够体现出性能差距
而N3E 为台积电的最后一个 FinFET 节点,N3E 及其后续节点有机会获得与台积电最成功的节点之一 N28 类似的地位。鉴于其动荡的历史,这将是一项艰巨的任务,但台积电已经多次证明了自己的能力,尤其是在其生态系统方面。台积电成为亚洲第一个市值突破万亿美元的科技公司,不是偶然
要不然说苹果是老大头呢,Ultra fusion技术,可以说就是一次对于跳脱芯片制程的尝试,PE核设计,大家也看到了现在三家归一,徒增笑料。包括手机soc概念的形成,专家模块的独立,都是在不断践行摩尔定律的后续
各家其实就已经在一计上下足了功夫,就难想象到26年左右的两纳米制程新工艺,大可能带来不了如此大的效果
一年已尽,春寒是否会压死幼苗尚未可知